
Publié le
Retrouver le contenu antérieur d'une URL : guide complet pour naviguer dans les versions archivées des sites web via Google
Le web est un espace en perpétuelle mutation sur lequel les pages se transforment ou disparaissent fréquemment. Face à cette volatilité, de nombreux internautes cherchent à consulter d'anciennes publications ou à retrouver des données effacées. Découvrir comment explorer les archives d'internet permet ainsi de reconstituer la mémoire numérique d'un domaine ou de vérifier des faits historiques essentiels.
Points clés
- La consultation des versions archivées d'un site permet de pallier la volatilité du web et de retrouver des contenus disparus ou modifiés.
- Google facilite l'accès aux archives web grâce au cache et à une collaboration récente intégrant des liens vers des services d'archivage directement dans ses résultats.
- L'utilisation d'opérateurs de recherche avancés permet d'isoler précisément des pages ou des données spécifiques encore présentes dans l'index de Google.
- La Wayback Machine, gérée par Internet Archive, constitue la référence pour explorer l'évolution historique de milliards de pages web via une interface chronologique.
- Des outils complémentaires comme archive.today permettent aux utilisateurs d'effectuer manuellement des captures d'écran ou de texte pour garantir la traçabilité des données.
- Les propriétaires de sites web conservent le droit de restreindre l'archivage de leurs espaces sur ces différentes plateformes.
Google et les archives web : comment accéder aux versions antérieures d'une page
Lorsqu'une page n'est plus en ligne, les internautes exploitent souvent les moteurs de recherche pour dénicher un instantané sauvegardé. En effectuant des recherches approfondies, notamment via des portails comme www.ma-piece-smartphone.com qui s'intéressent aux outils technologiques, on constate que la consultation d'une version passée répond à des besoins variés d'analyse documentaire.
Le cache Google : consulter une version récente d'une URL disparue
Le moteur de recherche enregistre régulièrement des copies temporaires pour indexer les pages. Historiquement, cette sauvegarde servait de secours immédiat pour afficher un contenu temporairement inaccessible. Une collaboration officielle annoncée le 16 septembre 2024 entre le moteur et un grand service d'archivage a d'ailleurs permis d'intégrer directement un lien vers les versions antérieures au sein des résultats de recherche, facilitant l'accès au patrimoine numérique.
Les opérateurs de recherche Google pour retrouver des pages archivées
Pour retrouver des contenus spécifiques, l'utilisation de commandes ciblées dans la barre de recherche optimise considérablement les résultats. Ces syntaxes permettent de cibler précisément une adresse web, d'isoler un domaine précis ou d'identifier des résidus textuels encore présents dans les index du moteur avant leur disparition définitive.
La Wayback Machine et les autres outils pour explorer l'historique et l'évolution des sites web
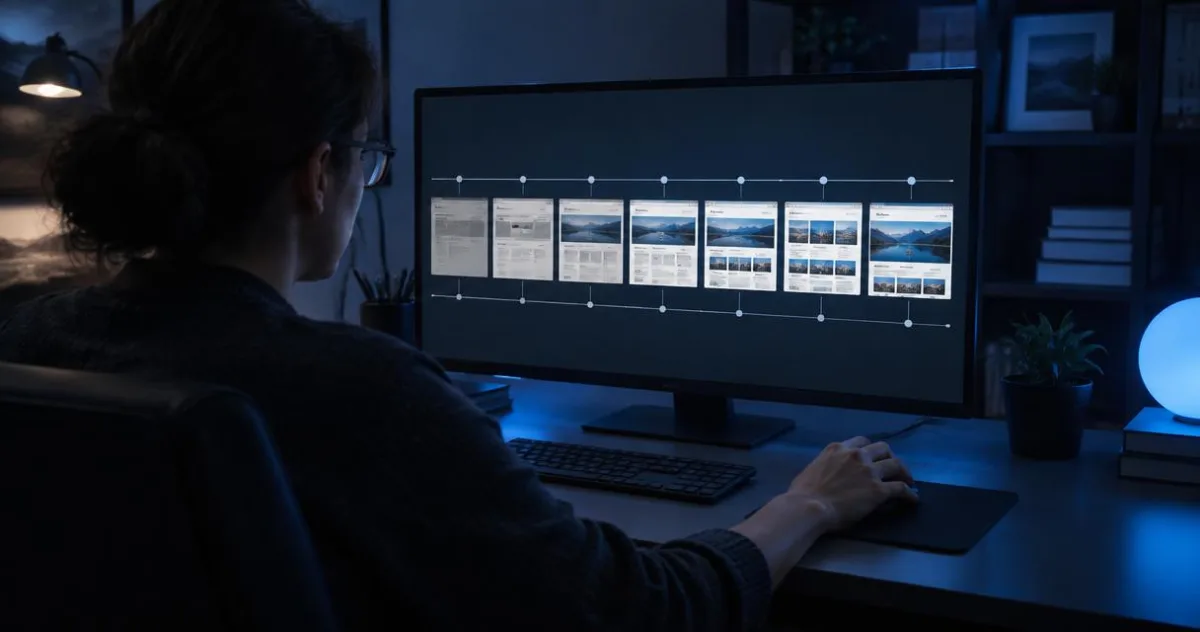
Au-delà des moteurs traditionnels, des plateformes dédiées sauvegardent la mémoire du net. Ces systèmes automatisés parcourent le réseau en continu afin d'immortaliser des milliards de pages pour les générations futures.
Naviguer dans les archives de la Wayback Machine : voir les anciennes versions d'une URL
L'outil le plus emblématique reste sans conteste la Wayback Machine gérée par Internet Archive. Ce service public indexe plus de 85 milliards de pages et accueille plus de 20 téraoctets d'informations supplémentaires chaque mois. Pour afficher l'historique complet d'une page, la procédure demeure très intuitive :
- Entrer l'adresse du site dans le champ de recherche de la plateforme.
- Sélectionner l'année souhaitée sur la frise chronologique interactive.
- Cliquer sur la date surlignée dans le calendrier pour charger la capture voulue.
Cette démarche permet d'observer l'évolution éditoriale d'un portail tout en respectant la volonté des propriétaires qui conservent le droit de restreindre l'archivage de leurs espaces.
Compléter sa recherche : autres ressources pour consulter des contenus archivés sur internet
D'autres dispositifs complémentaires comme archive.today permettent d'archiver manuellement une capture instantanée d'un texte ou d'une page complète. Ces outils tiers renforcent la traçabilité des données publiques et offrent aux chercheurs comme au grand public une solution robuste pour retracer l'histoire du web moderne sans perdre la trace des publications effacées.